Un projet vibe codé de 10 000 lignes, entièrement refactoré en 1 h 45 avec un seul prompt
Comment un prompt de quinze minutes a mis un projet sans tests sous le plus haut contrôle qualité : un objectif que l'agent vérifie lui-même, la couverture d'abord, un cliquet contre les raccourcis.
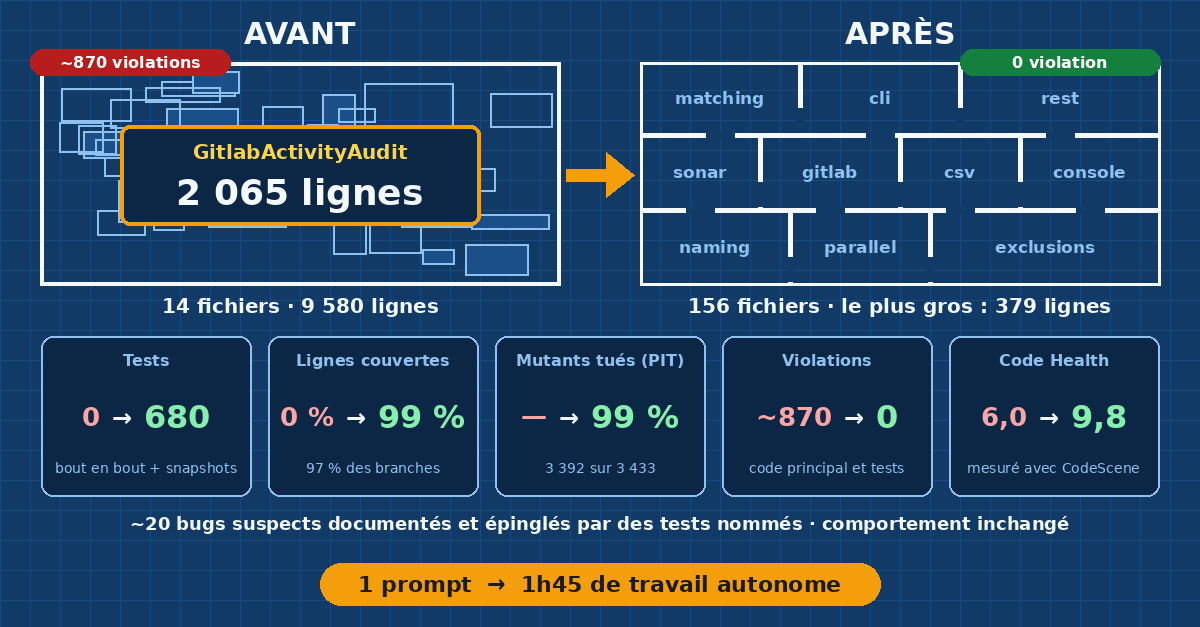
J’ai un projet Java en ligne de commande, vibe codé : 14 fichiers, 9 580 lignes, aucun test, un fichier de 2 065 lignes et environ 870 violations des règles d’analyse statique. Je lui ai donné un prompt écrit en quinze minutes. L’agent a travaillé seul pendant 1 h 45, de 00 h 42 à 02 h 27. Le projet compte maintenant 156 fichiers, le plus gros faisant 379 lignes, 680 tests, 99 % de lignes couvertes, et il passe une commande unique, ./verify, qui enchaîne huit contrôles automatiques.
Avant de lancer l’agent, j’étais certain de deux choses : rien ne serait cassé, et le résultat irait là où je voulais. Cet article explique d’où venait cette certitude.
Le point de départ : 14 fichiers, 9 580 lignes, aucun test
Le projet audite l’activité de dépôts GitLab en s’appuyant sur des données SonarQube. Il fonctionne, mais tout tient dans quelques gros fichiers, dont GitlabActivityAudit qui fait 2 065 lignes, et rien ne vérifie qu’une modification n’abîme pas autre chose. Les outils d’analyse statique relevaient environ 870 violations.
Ce que j’ai demandé : une commande qui doit passer au vert
Le prompt décrit avant tout un état final : la commande ./verify doit passer entièrement au vert. Elle enchaîne Spotless pour le formatage, Checkstyle, Error Prone avec NullAway, PMD, les tests avec un seuil de couverture de 90 % des lignes et 85 % des branches, et un cliquet que je décris plus bas. L’option --full ajoute CPD pour le code dupliqué et PIT, un test de mutation, avec un seuil de 85 %.
Voici le prompt, raccourci pour la lecture (l’original est plus long) :
- Couvre le projet avec des tests qui permettent un gros refactoring.
- Utilise le test de mutation pour vérifier cette couverture.
- Lance
./verifypour faire ressortir toutes les violations.- Corrige-les dans l’ordre que tu juges le plus pertinent.
- Installe
./verifyen hooks git et valide qu’ils fonctionnent.Sauvegarde dans
QUALITY_LOG.mdtout choix douteux que tu dois faire pour passer les vérifications. Fournis des preuves : couverture avant, couverture après, diff éventuel sur les règles, rapport de./verify.
L’ordre compte : la couverture d’abord, la structure ensuite. Le journal QUALITY_LOG.md permet à l’agent de me signaler ses choix discutables, j’y reviens plus bas. Quant aux preuves demandées en fin de prompt, elles tiennent sur une page et me suffisent pour relire : le diff sur les règles me montre tout de suite si l’agent a desserré un contrôle.
Ce qui est sorti de la nuit
| Avant | Après | |
|---|---|---|
| Fichiers | 14 | 156 (le plus gros : 379 lignes) |
| Tests | 0 | 680 |
| Lignes couvertes | 0 % | 99 % (97 % des branches) |
| Mutants tués (PIT) | non mesuré | 99 % (3 392 sur 3 433) |
| Violations d’analyse statique | environ 870 | 0 |
| Code Health (CodeScene) | 6,0 | 9,8 |
L’agent a aussi relevé une vingtaine de comportements qui ressemblent à des bugs. Je ne voulais pas qu’il les corrige pendant un refactoring. Il les a documentés et épinglés par des tests nommés, le comportement reste inchangé, et je décide plus tard.
Pourquoi j’étais sûr de ne rien casser
Le refactoring ne commence qu’une fois le comportement protégé. Les tests écrits en premier sont des tests de caractérisation : ils lancent l’outil de bout en bout contre de faux serveurs GitLab et SonarQube, et comparent sa sortie à des instantanés (avec la bibliothèque Selfie). Si le refactoring change une ligne de ce que l’outil produit, un instantané casse.
Une couverture de 99 % ne prouve pas que ces tests vérifient quelque chose : une ligne exécutée n’est pas une ligne contrôlée. C’est le rôle du test de mutation. PIT modifie le code par petites touches (un > devient >=, un return est supprimé) et vérifie qu’au moins un test échoue. Sur 3 433 mutations, 3 392 ont été détectées. Le filet de sécurité a donc été éprouvé avant le premier refactoring.
C’est la méthode que j’appelle 3P et que j’ai mise dans une skill : Protéger le comportement existant avec des tests rapides et sales, vérifier le filet en cassant volontairement quelque chose de petit, Préparer le terrain par un refactoring qui ne change aucun comportement, puis Produire la fonctionnalité en TDD. Ici, je n’ai utilisé que les deux premières étapes. Mais rien n’empêche de s’en servir pour ajouter une fonctionnalité dans n’importe quel code legacy, de la même façon : la protection d’abord, la nouveauté ensuite.
Pourquoi l’agent allait là où je voulais
L’objectif est évaluable par l’agent lui-même. Il n’a pas besoin de moi pour savoir où il en est : il lance ./verify, lit ce qui échoue, corrige, recommence. Je n’ai décrit aucune structure cible. Le découpage en 156 fichiers, avec des paquets comme matching, sonar, gitlab, csv, console, naming, parallel ou exclusions, vient de l’agent. Ce que j’ai fixé, ce sont les seuils : ceux de Checkstyle et de PMD, la couverture, la mutation.
Chaque itération rapproche de l’état final ou fait échouer un test, et l’agent choisit librement le chemin.
Le cliquet : les problèmes existants restent, aucun nouveau n’entre
Un objectif mesurable a une faille : l’agent peut passer au vert en desserrant la mesure, en baissant un seuil de couverture, en ajoutant un @SuppressWarnings ou en désactivant un test. Le cliquet ferme cette porte. Son nom vient de la clé à cliquet, qui ne tourne que dans un sens. La règle tient en une phrase : les problèmes existants peuvent rester, aucun nouveau n’est admis, et personne ne desserre un contrôle discrètement.
Concrètement, un petit outil compare l’arbre de travail à une référence git. Un seuil minimum ne peut pas baisser, un seuil maximum ne peut pas monter, un contrôle ne peut pas disparaître. Le nombre de marqueurs de suppression (@SuppressWarnings, NOPMD, CHECKSTYLE:OFF, @Disabled) ne peut pas augmenter. Une règle Error Prone passée en désactivée ou en simple avertissement est détectée. Un commit qui porte une ligne Ratchet-Override: transforme l’échec en avertissement : la dérogation reste possible, mais c’est une décision humaine, visible dans l’historique.
Pendant la nuit, le cliquet a refusé trois nouveaux @SuppressWarnings que l’agent avait ajoutés.
Le journal de qualité : l’agent signale ses choix discutables
Un agent qui travaille seul pendant 1 h 45 prend beaucoup de décisions que je ne verrai pas. La section du prompt sur QUALITY_LOG.md lui demande de les consigner quand elles sont discutables : un compromis, un raccourci, un endroit où il n’était pas sûr. Je lis ce journal à la place de 156 fichiers.
Le journal a servi une deuxième fois. J’ai lancé sur le résultat une revue automatisée (CodeScene, un agent « clean coder », un agent « architecte » et une expérience de changement de comportement) et j’ai confronté ses constats au journal. L’écart entre les deux m’a donné de nouvelles règles de design : un fichier ARCHITECTURE.md et des tests ArchUnit qui imposent des couches, l’isolation entre les tranches du code, l’absence de cycle entre paquets, et une seule classe publique, celle de la commande. Ce sont des tests, donc ils tournent dans ./verify comme le reste. Cette deuxième vague mérite son propre billet.
Ce que cette certitude ne couvre pas
Les tests figent le comportement tel que mes faux serveurs le simulent. Sur 3 433 mutants, 41 ont survécu. Et la vingtaine de bugs suspects est toujours là, volontairement. Le cadre garantit que le comportement observé par les tests ne change pas. Il ne garantit pas que le programme est juste.
Ils appliquent la même recette
Je ne suis pas le seul à observer ça. Ces retours publiés suivent la même recette : un objectif que l’agent vérifie lui-même, et des règles qu’il ne peut pas contourner.
- Anthropic : un compilateur C de 100 000 lignes écrit par 16 agents, guidés par des suites de tests existantes. Le vérificateur doit être presque parfait, sinon l’agent résout le mauvais problème.
- OpenAI : un million de lignes en cinq mois par trois ingénieurs, bornées par des règles mécaniques.
- Rakuten : sept heures d’autonomie sur vLLM, 99,9 % de précision numérique face à la référence.
- Stripe (via InfoQ) : plus de 1 300 pull requests par semaine, avec lint et tests déterministes et deux tours d’intégration continue au plus.
- Airbnb (via InfoQ) : 3 500 fichiers de tests migrés en six semaines au lieu de 18 mois.
- Meta : 49 % des tests générés à partir de mutants n’ajoutent aucune couverture de lignes, d’où l’intérêt du test de mutation.
Quel lot de travail devient raisonnable maintenant ?
Transformer 10 000 lignes sans test en code testé, découpé et contrôlé demandait des semaines d’une équipe, et on ne le faisait pas. Ça a pris quinze minutes de prompt et 1 h 45 d’attente. Les lois physiques du développement logiciel ont changé, et notre idée de ce qui vaut la peine d’être tenté n’a pas suivi.
Dans votre backlog, cherchez les chantiers dont on sait décrire l’état final de façon vérifiable : tous les tests de la nouvelle version au vert, un module couvert à 90 %, plus aucune violation. Les migrations, les montées de version, la couverture d’un module legacy et la mise en conformité d’un code ancien entrent souvent dans cette catégorie. Demain, que pourriez-vous faire de votre backlog avec cette approche ?
Pour aller plus loin
- La skill legacy-3p : Protéger, Préparer, Produire.
- Dans la même série : Relire des PR faites par l’IA, Pourquoi on ne délègue pas la revue de code et Comment déléguer la revue de code à des agents.
Johan Martinsson