Pourquoi on ne délègue pas la revue de code à l'IA
Les agents écrivent le code et les humains relisent tout. Cinq raisons, surtout psychologiques, qui nous empêchent de commencer à déléguer la revue.
« Une revue de code faite par l'IA, ce n'est pas fiable. Du coup, je la fais à la main. »
Ce raisonnement tient en deux phrases et il paraît solide. Dans le billet précédent, j’ai décrit ce qu’il produit : des agents qui écrivent beaucoup de code, des humains qui relisent tout, et beaucoup de monde qui le vit mal. Cette fois, je cherche ce qui nous empêche d’en déléguer ne serait-ce qu’une partie. Je vois cinq freins.
1. La peur de l’erreur qu’on ne verra pas
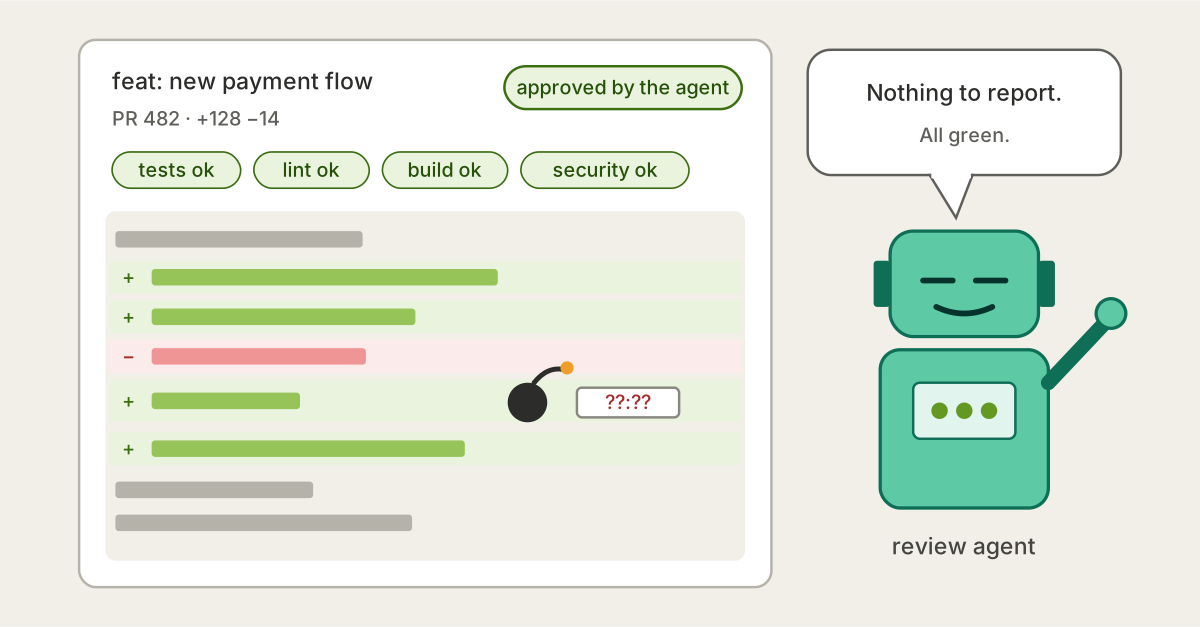
Ce qui fait peur, ce sont les erreurs graves que l’agent pourrait laisser passer : une faille de sécurité, un bug grave, qui traverse la revue sans bruit et qu’on découvre des semaines plus tard en production. Quand la PR est relue par mes collègues, je connais leurs forces et leurs angles morts. Avec un agent, je ne sais pas quand je m’en rendrai compte, ni combien ça me coûtera à ce moment-là.
Pour beaucoup, cette peur a une origine précise. On a essayé une fois, l’agent a raté quelque chose d’évident, et on n’a pas recommencé. Une erreur a suffi. Et on se dit que la prochaine, on ne la verra peut-être pas.
2. On confond déléguer et réussir à 100 %
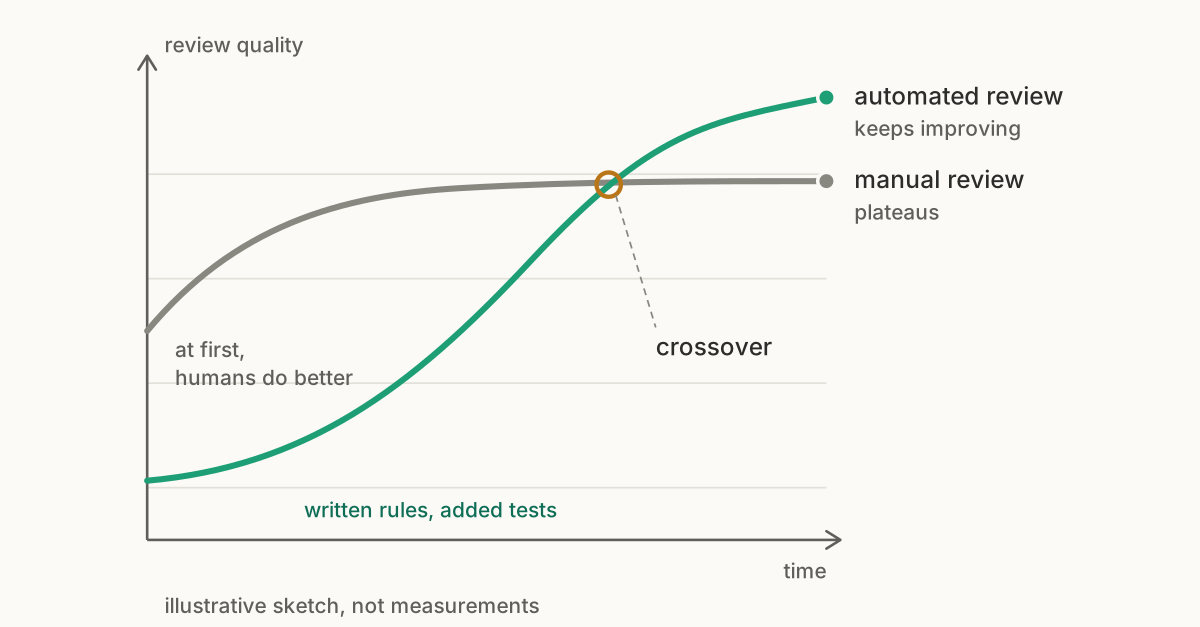
Si l’agent valide tout, il faut qu’il ait raison tout le temps. Comme il n’y arrivera pas, on ne commence pas. Ce raisonnement saute une étape : déléguer partiellement ne demande pas d’atteindre 100 %. On peut laisser l’agent faire la revue, corrections comprises, et repasser derrière lui jusqu’à avoir assez confiance. On peut aussi essayer plusieurs variantes de revue sur des PR déjà relues, et ne garder que celles qui tiennent la route. J’y reviens dans le prochain billet.
La recherche DORA sur la performance des équipes de livraison logicielle va dans ce sens. Dans le rapport Accelerate State of DevOps 2019, les organisations qui imposaient un processus d’approbation formel et lourd avaient 2,6 fois plus de chances d’être parmi les moins performantes. Le rapport ne dit pas pourquoi. Mon interprétation : un contrôle manuel plafonne, alors qu’un contrôle automatisé s’améliore à chaque règle qu’on lui ajoute. C’est pareil pour la revue : commencer à déléguer, même mal, c’est se donner quelque chose à améliorer.
3. On n’a jamais explicité comment on relit
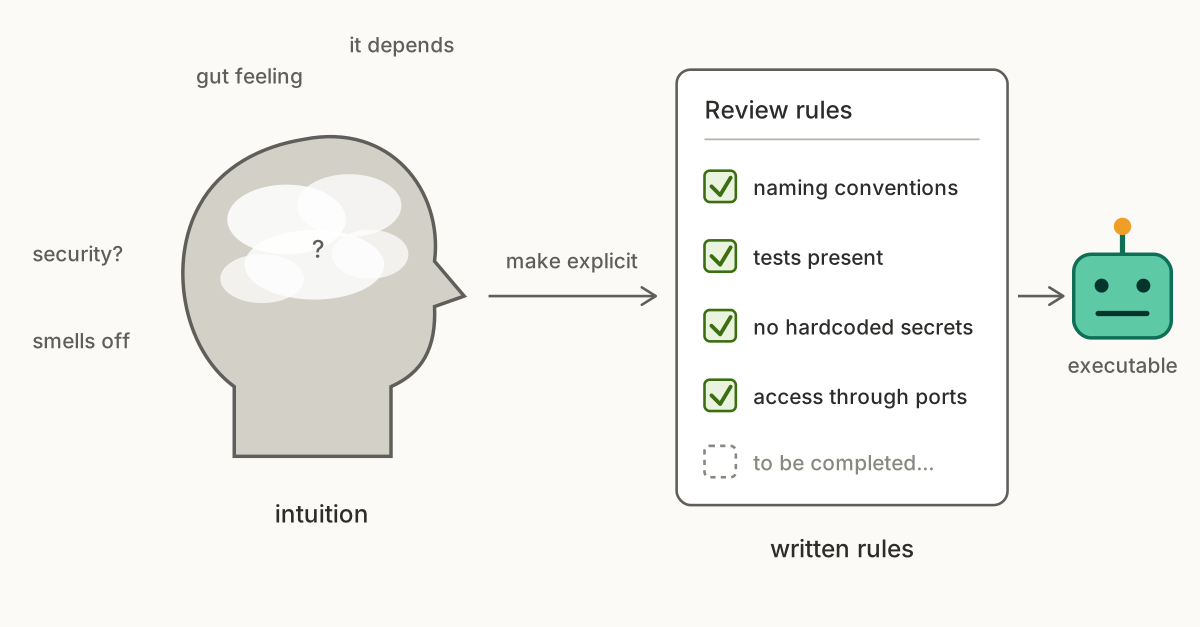
Quand on relit une PR, on le fait à l’intuition. Si on se demande ce qui compte vraiment pour nous et ce qu’on regarde en premier, la réponse ne vient pas tout de suite. Et d’une PR à l’autre, on ne relit pas tout à fait de la même façon. C’est souple : on relit une PR critique autrement qu’un renommage. Mais c’est aussi irrégulier, et une machine qui suit des règles écrites ne l’est pas.
Il y a au moins un indice que ça aide. Dans un papier présenté à un atelier de l’ICML 2026, un petit modèle relecteur inspecte une base de code Python contenant 11 backdoors insérées. Sans contrainte ni outil, il en retrouve 54,5 %. Avec des contraintes imposées par l’outillage sur le code et un petit outil de documentation, il monte à 90,9 %. C’est un petit jeu de données synthétique, mais le résultat est net : le relecteur trouve mieux quand on lui dit quoi vérifier.
4. Les LLM sont en dents de scie
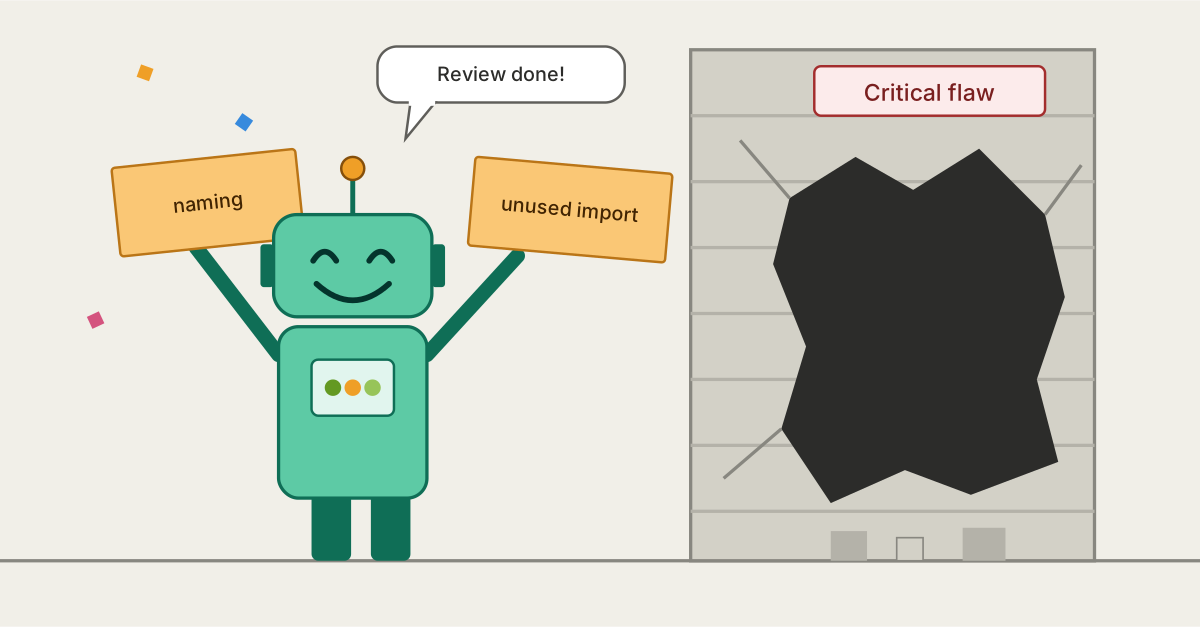
Les LLM sont excellents sur certaines tâches et complètement à côté sur d’autres, et on ne sait pas encore sentir à l’avance lequel des deux on va avoir. Andrej Karpathy appelle ça la jagged intelligence, à partir de modèles qui résolvent des problèmes difficiles mais se trompent pour savoir si 9,11 est plus grand que 9,9 (son message d’origine). Une étude de Harvard, Wharton et BCG parlait déjà de « frontière technologique en dents de scie », et Ethan Mollick l’a vulgarisée dans Centaurs and Cyborgs on the Jagged Frontier.
Imaginez confier la revue à un collègue qui, un jour sur deux, fait un travail remarquable et, l’autre jour, passe complètement à côté. Vous ne lui confieriez pas grand-chose.
5. Déléguer à un agent passe par l’écrit
Avec un collègue, on peut dire « fais-le avec moi quelques fois, et ensuite tu sauras ». Il observe, il comprend ce qui nous importe, et on lâche prise progressivement. Avec un agent, cette transmission par l’observation n’existe pas : ce qu’on n’a pas écrit, il ne le sait pas.
On peut contourner en partie. On fait parcourir à un agent tout le contenu du projet ainsi que les commentaires laissés sur les PR passées, et on lui demande d’en tirer un modèle de ce qui nous importe en revue. Ce n’est pas parfait, mais l’agent récupère une partie de ce qu’un collègue apprendrait en nous regardant faire.
Et maintenant ?
Ces cinq freins sont réels, mais le simple fait de les expliciter permet de les traiter, et l’agent fait alors assez facilement mieux qu’un humain.
Dans le prochain billet, je vous raconte comment nous faisons aujourd’hui, et ce que j’ai enfin le temps de faire à la place.