Comment déléguer la revue de code à des agents
Comment nourrir un reviewer IA, le tester sur des PR passées, et décider quand un humain doit regarder.
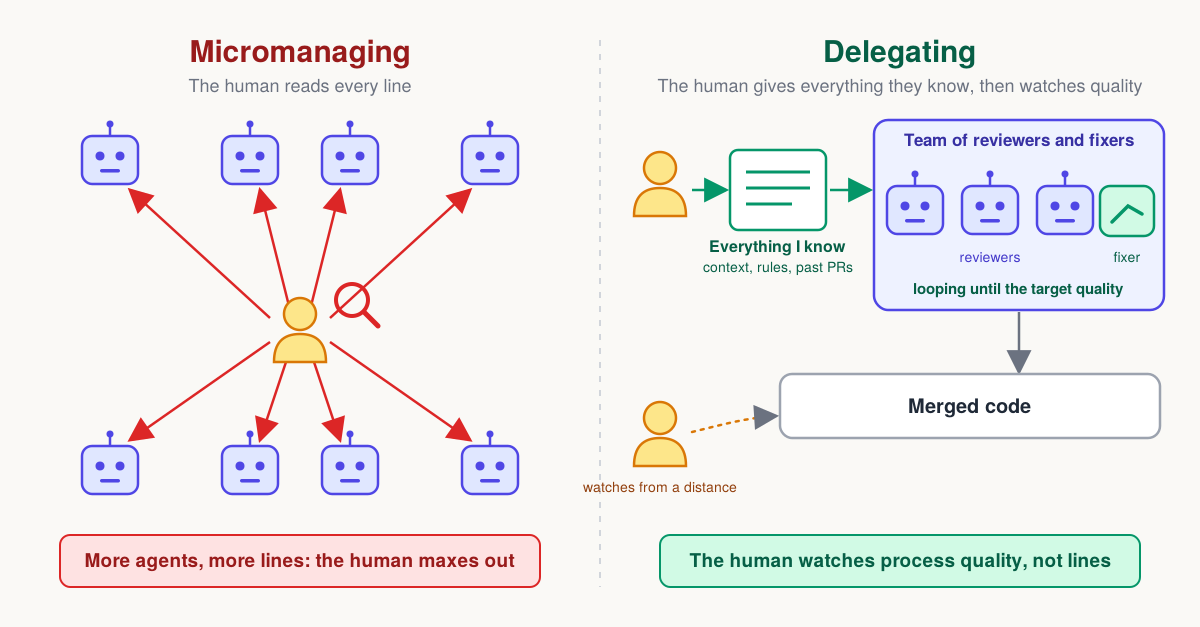
Imaginez un CTO dont l’équipe de développeurs grossit chaque jour et qui compte relire lui-même chaque ligne de code pour garder le contrôle. Personne ne croirait que ça tiendra encore demain. C’est pourtant ce que font beaucoup d’équipes avec les agents : ils produisent de plus en plus de code, et les humains relisent tout.
Je pense que notre rôle ne peut plus être de relire chaque ligne. Dans le premier article, je décrivais ce déséquilibre. Dans le deuxième, j’ai regardé ce qui nous empêche de déléguer la revue. Celui-ci porte sur la suite : comment s’y prendre concrètement.
Déléguer, c’est donner le contexte
Déléguer la revue est un vrai acte de délégation, comme avec un collègue : il faut donner à l’agent ce dont il a besoin pour réussir.
L’agent part avec une connaissance générale solide. Il a probablement lu dans son entraînement la plupart des livres sur le bon design, l’architecture, la sécurité, la lisibilité et les code smells. Cette connaissance existe, il faut aller la chercher avec les bonnes questions. Ce qu’il ne peut pas deviner, c’est votre projet, votre contexte, les goûts de votre équipe.
Où trouver la matière d’un code reviewer
Trois techniques se complètent :
- Les PR du passé. On laisse l’agent parcourir toutes les anciennes PR, leurs commentaires et leurs instructions, et en tirer des règles applicables, avec des exemples. Les humains de l’équipe y ont déjà écrit ce qui compte pour eux.
- Vous-même. On s’assoit et on transcrit tout ce qui est important, avec ses priorités. Ce que l’on sait du projet n’est souvent écrit nulle part, et l’agent ne le trouvera pas seul.
- Les revues en cours. À chaque revue, on voit ce que l’agent n’a pas vu, ce qu’il lui manque. On le verse dans sa base de connaissances.
Tester automatiquement un reviewer
Tester un prompt, c’est prendre un cas, le faire jouer, et analyser le résultat. Pour un reviewer, le cas existe déjà dans l’historique.
Le faire tourner sur des PR du passé. On choisit d’anciennes PR qui ont été relues en profondeur et on rejoue le reviewer dessus. Retrouve-t-il au minimum ce qui avait été relevé à l’époque ? Ce score se chiffre, c’est ce qu’on appelle une récompense vérifiable, et c’est ce qui rend l’évaluation simple. On regarde aussi ce qu’il trouve en plus et ce qu’il rate, et on juge la pertinence des constats supplémentaires. On peut aller plus loin et laisser un agent adapter le prompt pour se corriger sur ces cas. Ces PR deviennent une base de test pour améliorer le reviewer.
Le faire tourner en parallèle de l’humain. Pendant un temps, l’humain et l’agent relisent les mêmes PR, et on ajoute au reviewer ce qui lui manque.
Continuer les revues manuelles jusqu’à ce qu’elles n’apportent plus rien. C’est une façon de se rassurer qu’on n’a plus grand-chose à dire. La limite : quand le niveau monte, on remarque d’autres détails, et on peut en trouver sans fin.
Plusieurs reviewers spécialisés qui s’accordent, et un correcteur en boucle
Pour une revue plus poussée, j’ai découpé mon reviewer unique en plusieurs reviewers spécialisés, chacun avec son angle (complexité, tests, architecture, sécurité, etc.), coordonnés par un agent principal. Le balayage devient beaucoup plus profond. J’ai également dû l’instruire de regarder au-delà du git diff : le contexte, la méthode, le fichier complet. Il lui faut aussi des instructions assez strictes pour ne pas s’arrêter après quelques trouvailles, mais chercher absolument tout.
Ensuite, j’ai introduit un correcteur qui tourne en boucle avec les reviewers jusqu’à atteindre un niveau de qualité élevé. Les reviewers voient le travail des autres et s’accordent, par l’intermédiaire de l’agent principal, sur ce qu’il faut corriger. Cette mise en boucle pose quelques problèmes d’implémentation, et je ferai probablement un billet sur cette expérience.
Dans ma bibliothèque, tout part de review-all, l’orchestrateur. Il ne relit rien lui-même : il fige le commit, lance en parallèle cinq reviewers (complexité, tests, architecture, sécurité, slop), puis publie leur synthèse sur la PR, avec un commentaire et un statut par reviewer. Tous suivent le même protocole : chaque constat est classé Critical, Major ou Minor, avec son fichier et sa ligne. S’il y a des choses à corriger, les mêmes reviewers valident le plan de correction puis vérifient le résultat, sans refaire de revue complète. Ensuite, le merge se fait automatiquement si la CI passe.
Si vous voulez partir de quelque chose qui fonctionne, vous pouvez vous servir dans l’Unlockers Skills Library, en open source. Pour essayer, demandez à votre propre agent de lire ce jeu de skills et de l’appliquer à l’une de vos PR.
Un score de risque pour décider où un humain doit regarder
Autre technique : faire donner un score de risque à la revue, puis laisser un approbateur décider s’il faut faire appel à un humain. Ce mécanisme de score n’est pas encore publié dans ma bibliothèque.
Reste à savoir comment scorer. Plutôt qu’une note numérique, je conseille trois ou quatre niveaux, par exemple mineur, majeur, critique. C’est plus fiable avec un LLM, et c’est déjà le vocabulaire que les humains utilisent en réunion pour classer les problèmes. Plusieurs scores peuvent s’agréger pour donner une image d’ensemble.
Pour détecter les erreurs du scoring lui-même, un humain relit en plus quelques PR tirées au hasard, trois par exemple.
Une PR sans bug peut être mergée, le design se revoit plus tard
Dans un projet comme le noyau Linux, seuls les mainteneurs qui connaissent le projet peuvent merger. À mon avis, cela répondait à deux besoins : éviter les bugs et les incohérences, et garantir que les détails importants du projet soient connus de celui qui décide.
Ces deux besoins sont aujourd’hui couverts autrement :
- La correction fonctionnelle se règle en amont. Sur certains projets, il est devenu facile d’atteindre une couverture de tests quasi totale, protégée par du mutation testing.
- La connaissance du projet se fournit aux agents. Un reviewer qui la possède dépasse de très loin ce qu’un humain peut tenir en tête.
Une PR qui passe ces deux filtres n’a probablement pas de bug, donc elle peut être mergée. Ce qu’un regard humain apporte encore, c’est le design : l’architecture, les mauvais patterns, un code qui devient sloppy. Le benchmark SlopCodeBench fait étendre leur propre code à 15 agents, itération après itération : l’érosion structurelle augmente dans 77 % des trajectoires, et leur code est 2,3 fois plus verbeux que celui de 473 dépôts open source. Il n’est pas forcément représentatif, car ces agents n’y disposent d’aucun harnais de qualité. Dans tous les cas, la PR n’est pas toujours le bon endroit pour le traiter. Corriger une dérive détectée peut transformer un petit incrément de fonctionnalité en refactoring global de la base de code.
Cette revue de design peut donc se faire en décalé, sur plusieurs PR, en regardant les évolutions récentes. J’ai un agent qui fait ce genre de revue à plus long terme : il relève les mauvaises odeurs, les problèmes apparus dernièrement et les refactorings opportunistes à faire au vu du travail réalisé.
Un ami a tenté l’expérience : la revue ne bloque plus le merge. Les développeurs ont dû se demander comment obtenir la qualité autrement, ce qui a fait appel à leur créativité.
Mon avis : le rôle des humains reste important, mais il ne se joue plus principalement dans une PR.
Le coût du refactoring est devenu très faible
Il y a aussi une raison économique. Avant, laisser entrer un code peu propre coûtait cher : sans tests complets, on ne pouvait pas le refactorer en sécurité, donc il fallait le bloquer à l’entrée. Avec les tests en place, changer une implémentation ne coûte presque rien.
L’autre jour, j’ai pris une base de code de 9 580 lignes, entièrement vibe-codée et sans aucun test. En un seul prompt et 1 h 45 de travail autonome de l’agent, je l’ai fait couvrir par des tests, découper en modules et nettoyer de tous les mauvais patterns que les outils automatiques détectent (le détail). S’accrocher par réflexe aux anciennes règles de revue n’a plus de justification.
Pour aller plus loin
- Unlockers Skills Library : mes agents et skills de revue, avec leur protocole commun.
Johan Martinsson